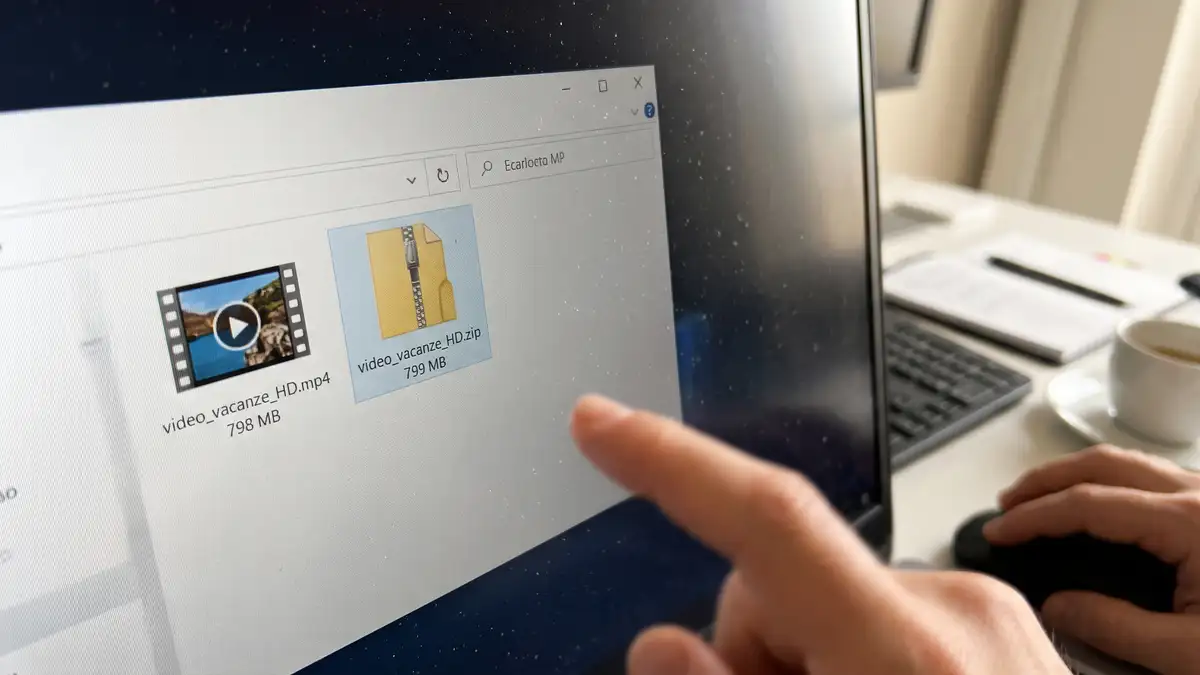
La procedura è quasi un riflesso condizionato: selezionare una manciata di file pesanti, cliccare con il tasto destro e scegliere “Comprimi in un file ZIP”. Il risultato atteso è un archivio snello, facile da inviare via email o archiviare su una chiavetta. Poi si controllano le proprietà dell’archivio appena generato e la sorpresa è inevitabile: un video da 800 MB è diventato uno ZIP da 798 MB. In alcuni casi, il file compresso risulta persino leggermente più pesante dell’originale.
I file compressi non diminuiscono di volume per magia, ma grazie all’eliminazione delle ridondanze nei dati. Quando un formato è già compresso alla fonte — come accade per filmati MP4, immagini JPEG o documenti Office moderni — un algoritmo come Deflate o LZMA non trova pattern ripetuti da accorciare e può solo creare un involucro che aggiunge metadati e overhead.
Come fa un computer a ridurre le dimensioni di un file
I programmi di archiviazione generici (come ZIP, RAR o 7-Zip) lavorano con algoritmi di compressione senza perdita, detti lossless. Il loro compito è ricostruire il file originale bit per bit, senza sacrificare alcuna informazione.
Per riuscirci cercano la ridondanza statistica. Se un documento di testo ripete per mille volte la parola “amministrazione”, l’algoritmo non riscrive ogni volta tutte le quattordici lettere: assegna alla parola un’etichetta breve — un simbolo o un codice numerico — e crea un indice che serve a ricomporre il testo al momento dell’estrazione. Più un file contiene sequenze regolari e prevedibili, più l’algoritmo riesce ad asciugarlo.
Un file di log, un codice sorgente, un file CSV o un database testuale non strutturato possono ridursi dell’80% o del 90% proprio perché contengono un numero elevato di pattern ripetuti.
L’entropia e il paradosso dei file già compressi
Il principio matematico alla base di questo comportamento risale alla teoria dell’informazione formulata da Claude Shannon nel 1948. In sintesi, un flusso di dati possiede un limite teorico di compressione legato alla sua entropia: più i dati appaiono casuali e privi di schemi, meno sono comprimibili.
I file multimediali che usiamo ogni giorno sono già stati compressi da encoder specifici:
- Immagini: formati come JPEG o WebP usano algoritmi con perdita (lossy) progettati sulla percezione visiva umana, eliminando dettagli invisibili all’occhio.
- Video e audio: contenitori e codec come MP4 (H.264, HEVC) e MP3 analizzano le differenze tra fotogrammi consecutivi o frequenze sonore, comprimendo i dati con un’efficienza irraggiungibile per uno strumento generico.
- Documenti moderni: le estensioni DOCX, XLSX e PPTX sono in realtà già archivi ZIP sotto mentite spoglie; basta rinominare un file Word in
.ziped estrarlo per scoprire la cartella di XML e immagini compresse che contiene.
Quando un software come 7-Zip o l’utility di sistema di Windows analizza questi file, trova un flusso di byte ad altissima entropia, privo di blocchi identici da raggruppare. Non trovando schemi utili, il motore di compressione si arrende e memorizza i dati quasi inalterati.
Quando l’archivio ZIP diventa più pesante del file di partenza
Esiste un fenomeno che sorprende molti utenti: comprimere un file già ottimizzato o molto piccolo può produrre un archivio più ingombrante dell’originale.
Ogni formato di compressione ha bisogno di una struttura di servizio, definita overhead. Un file ZIP memorizza l’intestazione, il nome del file, i permessi, le date di creazione e modifica, i checksum di integrità (come il CRC-32) e le tabelle necessarie al decompressore per interpretare i blocchi di dati.
Se l’algoritmo calcola che la riduzione del dato è pari a zero, deve comunque scrivere questi metadati su disco. Su file singoli o archivi composti da elementi già saturi, il peso dei metadati supera il guadagno di compressione, determinando un bilancio negativo.
Per limitare lo spreco di tempo e memoria, gli algoritmi moderni effettuano un test preliminare: se un blocco di dati compresso risulta più grande del blocco sorgente, il software scarta l’operazione e scrive il blocco in modalità “store”, salvando i dati così come sono. Il risultato finale è un file che pesa esattamente quanto la somma dei file contenuti, più i byte dell’indice.
Quando ha ancora senso creare un archivio
Capire che un video non si rimpicciolisce all’interno di uno ZIP evita inutili attese e carichi di lavoro sulla CPU. L’archiviazione, tuttavia, non serve solo a risparmiare megabyte.
Raggruppare centinaia di file piccoli in un unico archivio velocizza drasticamente i trasferimenti su reti locali e cloud storage, poiché i file system gestiscono molto meglio una singola transazione sequenziale rispetto a migliaia di micro-operazioni di lettura e scrittura. Inoltre, un contenitore compresso permette di applicare una cifratura AES a 256 bit a dati sensibili o di proteggere l’integrità del pacchetto tramite codici di controllo contro i danneggiamenti di rete.
Se l’obiettivo è solo recuperare spazio su disco da una cartella di foto o filmati, lo strumento corretto non è un software di compressione generica, ma un convertitore di formato in grado di applicare una ricodifica mirata con codec più efficienti (come AV1 per i video o AVIF per le immagini).
DOMANDE FREQUENTI
Perché i file DOCX non si comprimono quasi mai con lo ZIP?
I documenti con estensione .docx, .xlsx e .pptx sono basati sullo standard OpenXML e sono già cartelle compresse in formato ZIP. Applicare una seconda compressione non riduce il file perché i dati interni sono già privi di ridondanze testuali evidenti.
Esiste un programma in grado di comprimere un file MP4 senza perdere qualità?
No con compressione senza perdita. I formati video usano già una compressione lossy spinta al limite delle frequenze percepibili; per diminuire la dimensione di un video occorre ricodificarlo, modificando bitrate, risoluzione o passando a un codec più avanzato.
La compressione “ultra” di programmi come 7-Zip può funzionare dove lo ZIP standard fallisce?
Algoritmi più complessi come LZMA2 con dizionari ampi possono recuperare percentuali minime su file misti, ma non possono superare i limiti fisici dell’entropia: su file multimediali già compressi, il guadagno rimane nullo o trascurabile a fronte di un uso intensivo di processore e RAM.
FONTI UTILIZZATE
- Bell Labs / Shannon, C. E. (1948) – A Mathematical Theory of Communication: la teoria formale sui limiti di entropia e comprimibilità dei dati.https://archive.org/details/bstj27-3-379
- IETF RFC 1951 – DEFLATE Compressed Data Format Specification version 1.3: documentazione tecnica dell’algoritmo alla base dei formati ZIP e GZIP.https://datatracker.ietf.org/doc/html/rfc1951
- PKWARE Inc. – ZIP File Format Specification: specifiche ufficiali sul formato .ZIP e la gestione di header e overhead di archiviazione.https://support.pkware.com/home/pkzip/developer-tools/appnote
Continua a scoprire curiosità, misteri, tecnologia e storie sorprendenti anche dall'app Veb.
Scarica gratis per Android